
Googleは6月3日(現地時間)、新しいAIモデル「Gemma 4 12B」を発表しました。
「ノートPCで高度なマルチモーダルAIを動かす」という野心的なテーマを現実に近づけるモデルで、。従来の軽量モデルE4Bと、より大規模な26B MoEモデルの中間に位置しながら、高い推論性能と軽量性を両立している点が特徴です。
Gemmaシリーズはすでに1.5億ダウンロードを突破しており、開発者コミュニティの勢いも強まっています。今回の12B追加は、その流れをさらに加速させる存在になりそうです。
エンコーダーを排した「統合アーキテクチャ」
Gemma 4 12Bの最大の特徴は、画像・音声の専用エンコーダーを廃止した統合アーキテクチャにあります。
一般的なマルチモーダルモデルは、画像や音声を処理するために別のエンコーダーを用意します。しかしGemma 4 12Bは、視覚・音声入力をそのままLLMのバックボーンに流し込む設計を採用しています。
-
画像処理:軽量な埋め込みモジュールを通して LLM が直接処理します
-
音声処理:音声エンコーダーを完全に排除し、生の音声波形をテキストと同じ次元に射影して処理します
この大胆な構造により、レイテンシ削減・メモリ削減・処理効率の向上を同時に実現しています。
16GBメモリのノートPCで動作する
Gemma 4 12Bは16GBのVRAMまたはユニファイドメモリがあればローカルで動作します。つまり、一般的なノートPCでも高度なマルチモーダル推論やエージェント的な処理が可能になります。
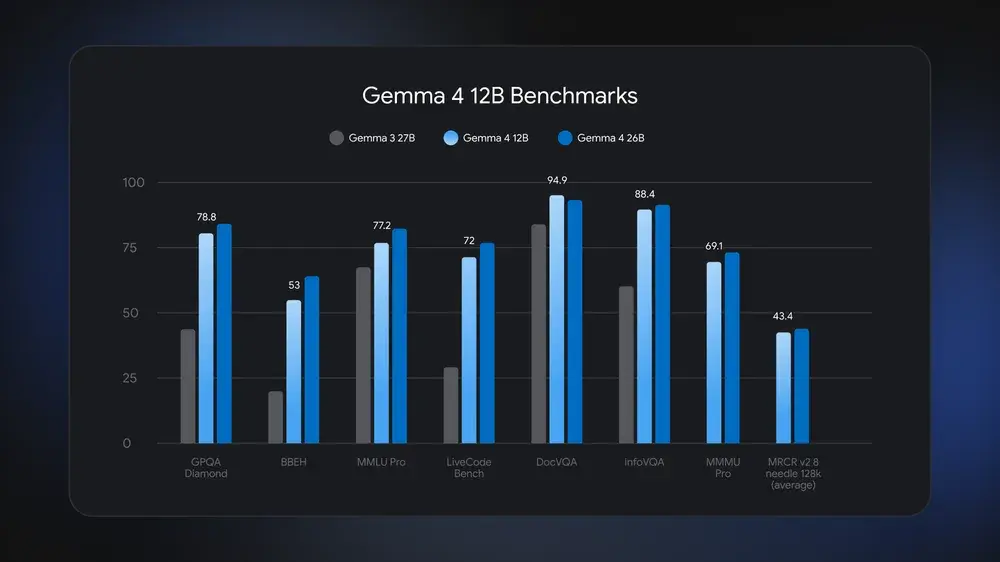
性能面では、26B MoEに迫るベンチマーク結果を示しており、サイズ以上の実力を持つモデルです。
開発者向けのエコシステムも充実
GoogleはGemma 4 12BをApache 2.0ライセンスで公開し、幅広いツールで利用できるようにしています。
- LM Studio、Ollama、Google AI Edgeアプリなどで即試せる
- Hugging FaceやKaggleからモデルをダウンロード可能
- Transformers、llama.cpp、MLX、vLLMなど主要フレームワークに対応
- Unslothを使った効率的なファインチューニングも可能
- Google Cloudでのデプロイにも対応(Model Garden、Cloud Run、GKEなど)
さらに、Gemmaモデル向けの公式Skills Repositoryも公開され、エージェント開発の基盤が整いつつあります。
まとめ
Gemma 4 12Bは、「高性能×軽量×マルチモーダル×ローカル実行」という、これからのAIモデルに求められる要素をすべて押さえています。ノートPCでも高度なエージェントを動かせる未来が、いよいよ現実味を帯びてきました。